Daftar Isi
Perbedaan AI, machine learning, dan deep learning terletak pada cakupannya. AI adalah bidang paling luas, machine learning merupakan salah satu pendekatan di dalam AI, sedangkan deep learning adalah bagian dari machine learning yang menggunakan jaringan saraf berlapis. Ketiganya saling berhubungan, bukan tiga teknologi yang selalu berdiri sendiri.
Perbedaan ini penting saat membaca berita teknologi, memilih pelatihan, atau menilai tawaran aplikasi. Sebuah produk bisa memakai AI tanpa model deep learning. Sebaliknya, sistem deep learning termasuk dalam pembelajaran mesin dan AI. Untuk gambaran yang lebih luas, baca dahulu pengertian AI dan cara kerjanya.
Ringkasan perbedaan AI, ML, dan deep learning
| Aspek | AI | Machine learning | Deep learning |
|---|---|---|---|
| Cakupan | Bidang luas tentang kemampuan cerdas pada sistem. | Pendekatan AI yang mempelajari pola dari data. | Pendekatan ML dengan jaringan saraf berlapis. |
| Metode | Dapat mencakup aturan, pencarian, penalaran, dan pembelajaran. | Misalnya regresi, pohon keputusan, dan pengelompokan. | Berbagai arsitektur jaringan saraf dalam. |
| Contoh tujuan | Memecahkan masalah atau mendukung keputusan. | Memprediksi permintaan atau mengelompokkan data. | Mengenali pola kompleks pada gambar, audio, atau teks. |
| Yang dinilai | Apakah sistem mencapai tujuan secara tepat. | Apakah pola berlaku pada data baru. | Apakah kualitas hasil sepadan dengan kebutuhan data dan komputasi. |
Hubungan tersebut juga dijelaskan dalam panduan Google Cloud tentang AI, ML, dan deep learning. Namun, tabel ini merupakan ringkasan: kebutuhan setiap proyek tetap bergantung pada masalah, data, dan rancangan sistemnya.
Apa yang membedakan AI dari machine learning?
AI mencakup lebih dari pembelajaran dari data. Sistem dapat menggunakan pengetahuan dan aturan yang dirancang manusia untuk melakukan penalaran. Dalam machine learning, pengembang menggunakan data untuk melatih model agar mengenali hubungan yang berguna bagi tugas tertentu.
Perhatikan ilustrasi sederhana tentang pengelolaan stok. Sebuah aturan dapat berbunyi, “Jika persediaan kurang dari sepuluh barang, kirim peringatan.” Model prediksi dapat mencoba memperkirakan kebutuhan stok minggu depan dari riwayat penjualan dan faktor lain. Keduanya membantu operasi, tetapi aturan otomatis sederhana saja tidak cukup untuk menyebut sebuah produk sebagai AI.
Saat menilai produk, tanyakan cara sistem menghasilkan hasilnya. Apakah memakai aturan tetap, model yang dilatih, atau kombinasi keduanya? AWS membahas perbedaan AI dan machine learning dengan menempatkan ML sebagai salah satu cabang dari bidang yang lebih besar.
Apa yang membedakan machine learning dari deep learning?
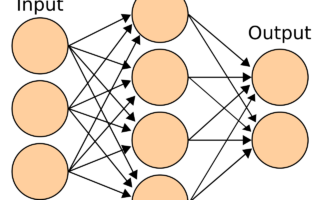
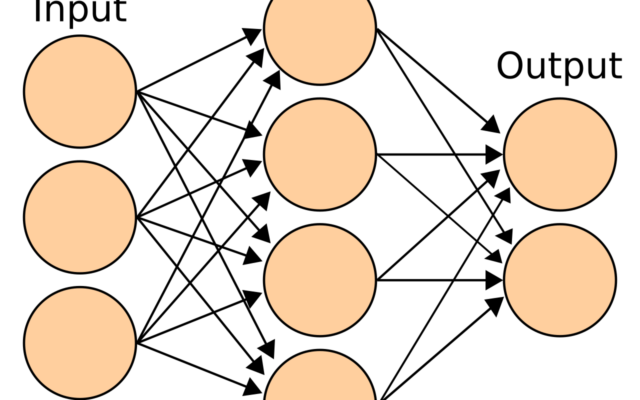
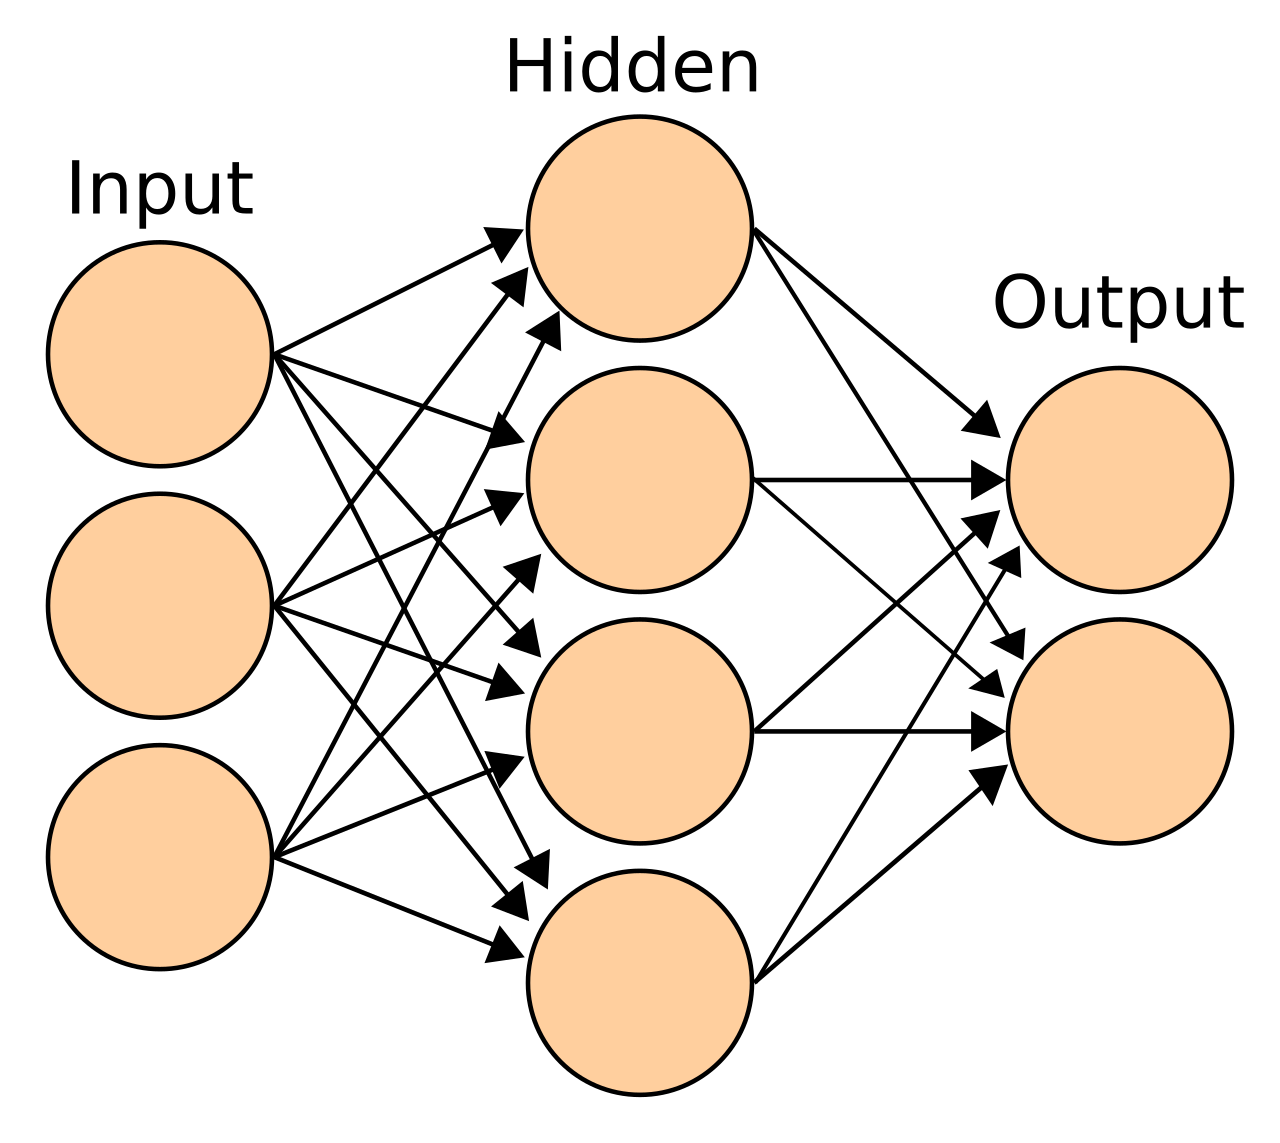
Deep learning menggunakan jaringan saraf dengan banyak lapisan untuk mempelajari representasi data. Pada pengolahan gambar, lapisan-lapisan itu dapat membantu membangun representasi dari informasi visual. Akan tetapi, jaringan tersebut merupakan model komputasi; ilustrasi neuron tidak berarti komputer memiliki otak atau kesadaran manusia.
Dalam beberapa metode ML, manusia banyak membantu memilih ciri atau fitur masukan. Misalnya, untuk memperkirakan keterlambatan pengiriman, fitur bisa berupa jarak, waktu keberangkatan, dan jenis layanan. Deep learning dapat mempelajari representasi kompleks dari masukan seperti gambar, tetapi tetap membutuhkan keputusan manusia mengenai data, tujuan, dan evaluasi.
Perbandingan AWS mengenai ML dan deep learning menjelaskan perbedaan pendekatan tersebut. Kebutuhan sumber daya sering lebih besar untuk melatih model deep learning berskala besar, tetapi tidak ada aturan bahwa setiap model deep learning selalu lebih mahal daripada setiap model lain.
Contoh: membaca permintaan pelanggan
Bayangkan sebuah toko ingin mengelompokkan pesan pelanggan ke dalam kategori pengiriman, pembayaran, dan pengembalian barang. Ilustrasi berikut menunjukkan beberapa pilihan pendekatan, bukan hasil uji sebuah produk.
1. Menggunakan aturan
Pengelola menetapkan kata tertentu sebagai petunjuk kategori. Pesan yang mengandung “resi” mungkin diarahkan ke pengiriman. Pendekatan ini mudah dimulai, tetapi ungkapan yang berbeda atau pesan dengan beberapa masalah sekaligus dapat menyulitkan.
2. Melatih model machine learning
Pengelola menyiapkan contoh pesan yang sudah diberi kategori, lalu melatih model klasifikasi. Kualitas label penting: pesan pembayaran yang salah ditandai sebagai pengiriman dapat mengajarkan hubungan yang keliru. Pengujian harus memakai contoh yang terpisah dari data pelatihan.
3. Memakai model bahasa berbasis deep learning
Aplikasi dapat memanfaatkan model bahasa untuk membaca konteks pesan dan menyusun kategori. Model siap pakai dapat mengurangi kebutuhan membangun semuanya dari awal, tetapi hasilnya tetap perlu diuji pada bahasa dan kebutuhan toko. Kelancaran jawaban bukan ukuran akurasi klasifikasi.
Pilihan terbaik ditentukan oleh hasil pengujian, biaya, serta cara menangani kesalahan. Jika tujuannya baru memilah sejumlah kecil pesan, sistem yang lebih rumit belum tentu memberi keuntungan praktis.
Di mana posisi AI generatif?
AI generatif mengacu pada kemampuan menghasilkan konten, misalnya teks, gambar, atau audio. Istilah ini menjelaskan jenis keluaran, sedangkan deep learning menjelaskan pendekatan teknis. Banyak sistem generatif modern memakai deep learning, tetapi pembahasan keduanya berada pada sudut yang berbeda.
Sebuah model dapat dipakai di dalam aplikasi yang menambahkan pencarian dokumen, penyimpanan percakapan, atau alat perhitungan. Karena itu, hasil yang dilihat pengguna merupakan hasil gabungan model dan fitur aplikasi. Jangan menilai seluruh aplikasi hanya dari nama model yang disebut dalam iklan.
Bagaimana menilai klaim “AI paling pintar”?
Sebelum membandingkan teknologi, tulis tugas yang benar-benar ingin diselesaikan. Untuk contoh toko tadi, beberapa ukuran yang berguna adalah ketepatan kategori, jumlah pesan yang perlu diteruskan ke manusia, waktu penanganan, dan biaya per permintaan.
- Periksa jenis data uji. Apakah bahasanya sesuai dengan pelanggan Anda?
- Pisahkan latihan dan pengujian. Nilai tinggi pada contoh yang telah dipakai melatih model tidak menunjukkan kemampuan pada kasus baru.
- Lihat jenis kesalahan. Salah mengategorikan keluhan serius dapat lebih merugikan daripada meminta pemeriksaan manusia.
- Bandingkan dengan cara sederhana. Ukur apakah tambahan biaya dan kerumitan memberi hasil yang cukup berarti.
Dokumentasi scikit-learn menyoroti kebocoran data sebagai sumber penilaian yang menyesatkan: informasi dari data uji tidak seharusnya ikut menentukan proses pelatihan. Dalam penilaian produk, mintalah penjelasan metode, bukan angka akurasi tanpa konteks.
Pertanyaan umum
Apakah deep learning selalu lebih bagus?
Tidak. Ukuran keberhasilannya adalah kesesuaian dengan tugas, kualitas data, biaya, dan hasil evaluasi. Kompleksitas yang lebih tinggi tidak otomatis memberi hasil lebih berguna.
Apakah memakai chatbot berarti melatih machine learning?
Tidak otomatis. Menggunakan model untuk menjawab permintaan berbeda dengan melatih model. Cara penyedia memakai data percakapan juga merupakan persoalan kebijakan layanan yang perlu diperiksa secara terpisah.
Harus belajar yang mana lebih dahulu?
Untuk pengguna aplikasi, mulailah dari konsep AI dan evaluasi keluaran. Untuk pengembangan model, pelajari dasar data, pemrograman, dan statistik sebelum memperdalam algoritma. Pilih jalur berdasarkan pekerjaan yang ingin dilakukan.
Jika tujuan Anda memakai alat untuk pekerjaan, lanjutkan ke panduan menggunakan AI di kantor. Untuk memahami mengapa jawaban yang lancar tetap bisa salah, baca halusinasi AI dan cara memeriksa jawaban.